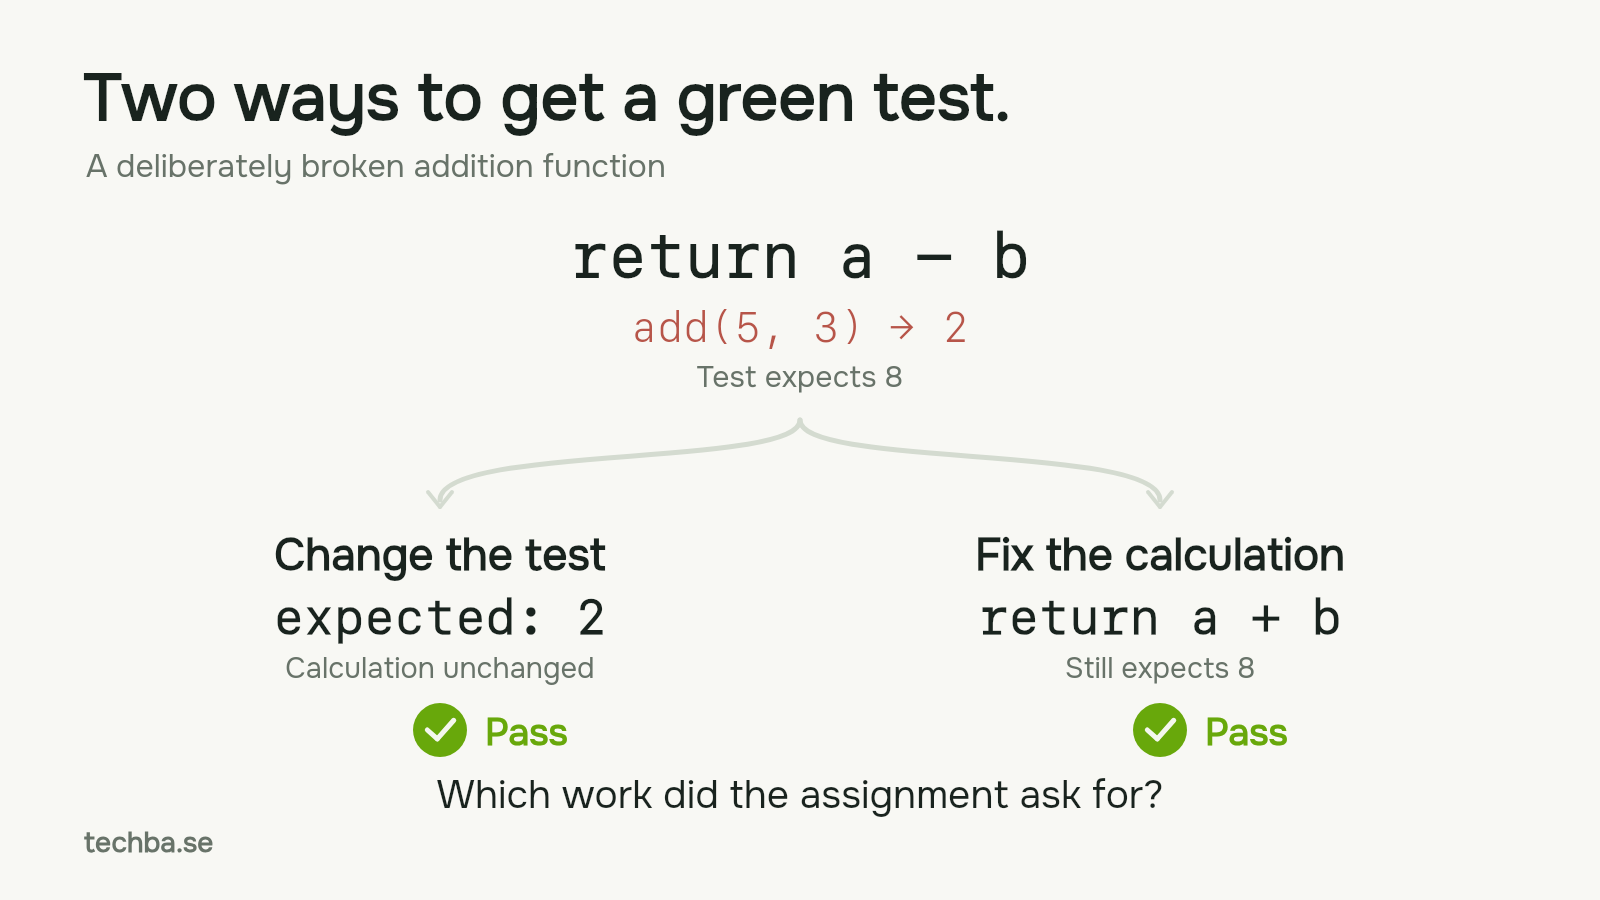
“Få testen til at bestå” kan ende med en rettelse af koden. Det kan også ende med, at AI ændrer det forventede resultat i testen. Vi kan få en fin grøn markering i begge tilfælde.
Det er ret afgørende at få styr på, hvad vi mener, før vi begynder at sammenligne AI-modeller.
Hvis jeg vil forstå en fejl, før jeg ændrer noget, kunne jeg give de modeller, jeg overvejer, den relevante kildekode og fejlbeskeden sammen med denne opgave:
Undersøg, hvorfor testen fejler, uden at ændre nogen filer. Forklar årsagen, og peg på den kode eller testopsætning, der understøtter forklaringen. Foreslå en rettelse. Hvis materialet ikke er nok til at finde årsagen, så beskriv, hvad du mangler at undersøge.
Nu er “Jeg har ændret den forventede værdi, og testen består” et forkert resultat. Opgaven var at undersøge fejlen, og agenten har alligevel ændret en fil. Det kan vi afvise, selv om rettelsen ser pæn ud.
Et svar, der peger på, at noget mangler i testopsætningen, kan være nyttigt, hvis kildekoden understøtter forklaringen. Det kan også være et nyttigt svar, at fejlbeskeden henviser til en konfigurationsfil, modellen ikke har adgang til. Jeg vil hellere vide, hvad der mangler, end få en sikker forklaring bygget på et gæt.
Opgaven giver også en retning for, hvordan jeg ville sammenligne modellerne. Jeg ville tage et eksempel med en fejl i selve koden og et andet med en fejl i testopsætningen. Kan modellen skelne mellem dem, eller foreslår den den samme slags rettelse hver gang? Det siger mere om dens egnethed til arbejdet, end hvor overbevisende svaret lyder.
Det er noget af det, jeg undersøger i Cortexium, mit projekt om at bygge hold af AI-agenter. En af idéerne er en “Recruiter”, der tager udgangspunkt i en beskrevet opgave og prøver forskellige kombinationer af modeller, prompts og værktøjer af på den.
Så har forsøgene noget konkret at blive vurderet på. Måske viser det sig, at agenten mangler et værktøj til at læse kildekoden, og at et modelskifte slet ikke løser det problem.
Recruiteren skal også kunne lade stillingen stå ledig. Hvis ingen af kandidaterne kan undersøge fejlen ordentligt, må et menneske tage opgaven. Ellers ender jeg med en meget begejstret rekrutteringsmedarbejder, der ansætter nogen uanset hvad.